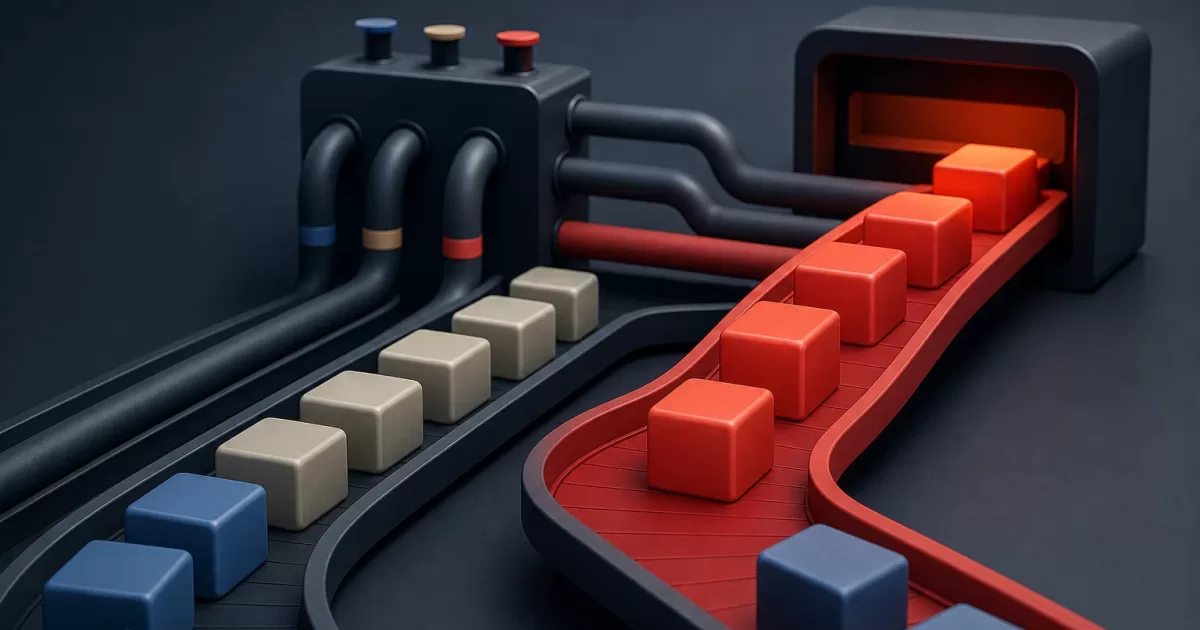
Una cola asíncrona evita que una petición web espere a que terminen tareas costosas, pero no resuelve por sí sola la competencia entre trabajos. El problema aparece cuando una importación, un reproceso o una campaña crea miles de mensajes y ocupa todos los consumidores. Una acción con impacto inmediato —confirmar un pedido, reservar inventario, bloquear una cuenta o enviar una notificación transaccional— queda detrás de trabajo que puede esperar.
Gestionar prioridades en colas PHP no consiste únicamente en añadir un campo numérico al mensaje. Es una decisión de arquitectura que debe reflejar el flujo de negocio, proteger dependencias limitadas y mantener un comportamiento predecible cuando aumenta la carga.
Clasifique el trabajo por impacto, plazo y coste
Antes de crear colas, construya un inventario de trabajos asíncronos. Para cada uno, identifique quién lo inicia, qué dependencia utiliza, cuánto suele durar, qué plazo de negocio tiene y qué ocurre si se retrasa. La urgencia no equivale necesariamente a importancia: una conciliación financiera puede ser muy importante, pero tolerar varias horas de espera; una validación de pago puede requerir respuesta rápida aunque su ejecución sea breve.
Una clasificación útil suele incluir cuatro clases de servicio:
- Crítica: acciones que protegen dinero, seguridad, consistencia o compromisos inmediatos. Deben tener una espera objetivo muy baja y capacidad reservada.
- Interactiva: trabajo iniciado por una persona o necesario para completar una experiencia cercana al tiempo real, como generar un documento solicitado desde la aplicación.
- Diferida: tareas necesarias, pero sin plazo inmediato, como sincronizaciones periódicas, resúmenes o actualizaciones de índices.
- Masiva: importaciones, migraciones, reindexaciones, campañas y reprocesos. Su volumen o coste exige limitar su ritmo incluso cuando no haya otra carga.
Registre también el coste por trabajo. Un mensaje que llama a una API con cuota limitada, ejecuta una consulta intensiva o procesa un archivo grande no debe competir de la misma forma que una actualización local breve. La clase de servicio debe expresar el plazo y el tipo de presión que el trabajo genera sobre el sistema.
Separe colas cuando necesite aislamiento real
Una cola única con prioridades puede servir si los trabajos tienen una ejecución homogénea, usan las mismas dependencias y el transporte ofrece una prioridad fiable. Sin embargo, el orden de recuperación no garantiza por sí mismo que exista capacidad: un trabajo masivo que ya está ejecutándose seguirá ocupando un worker, una conexión o una cuota externa.
Separe colas cuando exista alguno de estos límites:
- Los trabajos críticos y masivos tienen objetivos de espera claramente distintos.
- Un tipo de trabajo accede a una dependencia frágil o con límites de tasa, como una API de pagos, correo o ERP.
- La duración es muy desigual y los trabajos largos retienen procesos durante demasiado tiempo.
- Se requiere control independiente de despliegue, pausado, reintento o escalado.
- Un error o una entrada anómala de un flujo no debe degradar otro flujo.
En una aplicación PHP, el patrón más legible suele ser enrutar los mensajes a colas explícitas, por ejemplo critical, interactive, deferred y bulk. El componente de mensajería puede ser Symfony Messenger, Laravel Queues o una integración propia con el broker elegido; el principio no depende del framework. La prioridad dentro de una cola puede complementar esta separación para ordenar trabajos similares, no sustituir el aislamiento entre clases incompatibles.
Defina capacidad reservada y concurrencia máxima
Asigne consumidores por clase y establezca tanto mínimos como máximos operativos. La cola crítica necesita capacidad que no pueda ser absorbida por importaciones. La masiva, en cambio, debe tener un máximo de concurrencia para no saturar base de datos, CPU, almacenamiento o proveedores externos.
Evite configurar todos los workers para leer de todas las colas con preferencia absoluta por la crítica. Ese enfoque puede dejar capacidad ociosa si los consumidores reservados no pueden tomar otros trabajos, o provocar inanición si sí pueden hacerlo sin reglas. Una alternativa práctica es combinar:
- Workers dedicados a crítica e interactiva.
- Workers compartidos que atiendan diferida y masiva según cuotas.
- Límites por tipo de dependencia, no sólo por número total de procesos.
- Escalado basado en profundidad de cola y antigüedad de los mensajes, no exclusivamente en uso de CPU.
El número correcto no es universal. Debe partir de la concurrencia que toleran la base de datos y las APIs, de la duración observada y del objetivo de espera de cada clase.
Evite inanición y aplique backpressure
Dar preferencia a lo urgente no significa que lo diferido nunca deba terminar. Si siempre hay mensajes críticos, una política de prioridad estricta puede producir inanición: los trabajos de menor nivel envejecen indefinidamente. Establezca una regla de fairness medible, como procesar una cuota de mensajes diferidos tras un número limitado de críticos, o reservar una fracción pequeña de capacidad para trabajo no urgente.
La regla debe respetar los límites de las dependencias. Si crítica y masiva escriben en la misma tabla con bloqueos costosos, ejecutar ambas en paralelo puede empeorar la latencia. En ese caso, la cuota debe aplicarse al recurso compartido o conviene rediseñar el trabajo en lotes más pequeños.
El backpressure aparece cuando entra más trabajo del que puede completarse. No se arregla aumentando indefinidamente los workers. Defina cómo reaccionar:
- Limite el tamaño, la frecuencia o la concurrencia de importaciones desde el origen.
- Divida lotes en unidades reanudables y controle cuántas se publican a la vez.
- Aplace trabajo diferido con una programación explícita cuando la cola o una dependencia supere un umbral.
- Respete respuestas de límite de tasa con pausas y reintentos diferidos, en lugar de reintentos inmediatos.
- Comunique al producto cuándo una operación es aceptada para procesamiento y cuándo está realmente completada.
Es importante distinguir aceptación de ejecución: devolver que una importación ha sido recibida no implica que pueda iniciarse de inmediato. Esa transparencia evita que un cambio técnico se interprete como una promesa de disponibilidad instantánea.
Controle reintentos, lentitud e idempotencia
Los reintentos consumen capacidad y pueden convertirse en una carga prioritaria accidental. Clasifique los errores entre transitorios y permanentes. Un corte temporal de red puede justificar reintento con espera creciente y dispersión temporal; una validación inválida, un recurso inexistente o una credencial revocada debe ir a un circuito de revisión, no repetirse sin fin.
Establezca tiempo máximo de ejecución por tipo de trabajo. Un job lento no debe retener un worker indefinidamente. Si se puede dividir, procese páginas, archivos o segmentos en mensajes independientes que registren progreso. Si no, use límites estrictos, cancelación segura y un procedimiento para revisar los trabajos agotados.
La prioridad aumenta el riesgo de repetir efectos cuando un productor reenvía un mensaje o un consumidor falla después de llamar a una API externa. Diseñe handlers idempotentes: use una clave estable de operación, persista el estado de la transición y haga que procesar dos veces tenga el mismo efecto de negocio que procesar una. La deduplicación del broker puede reducir duplicados, pero no reemplaza la idempotencia en la aplicación ni en las integraciones externas.
Observe la espera, no sólo el tamaño de la cola
Una cola corta puede ocultar un problema si sus mensajes más antiguos esperan demasiado o si los consumidores fallan constantemente. Mida por clase de servicio la antigüedad del mensaje más viejo, el tiempo desde publicación hasta inicio, la duración de ejecución, el porcentaje de errores, reintentos y trabajos enviados a revisión.
Complete esas métricas con concurrencia activa, profundidad, tasa de entrada y salida, uso de conexiones, tiempos de las dependencias y límites de tasa recibidos. Las señales más útiles son: la espera crítica supera su objetivo, la cola masiva crece mientras su cuota está limitada, los reintentos dominan el tráfico o la capacidad reservada está ociosa durante picos de otra clase.
Configure alertas sobre tendencias y objetivos de servicio, no sólo sobre un número fijo de mensajes. Mil mensajes pueden ser normales en una importación; diez pueden ser graves si pertenecen a confirmaciones de pedido que llevan varios minutos esperando.
Ejemplo de flujo compartido y lista de implantación
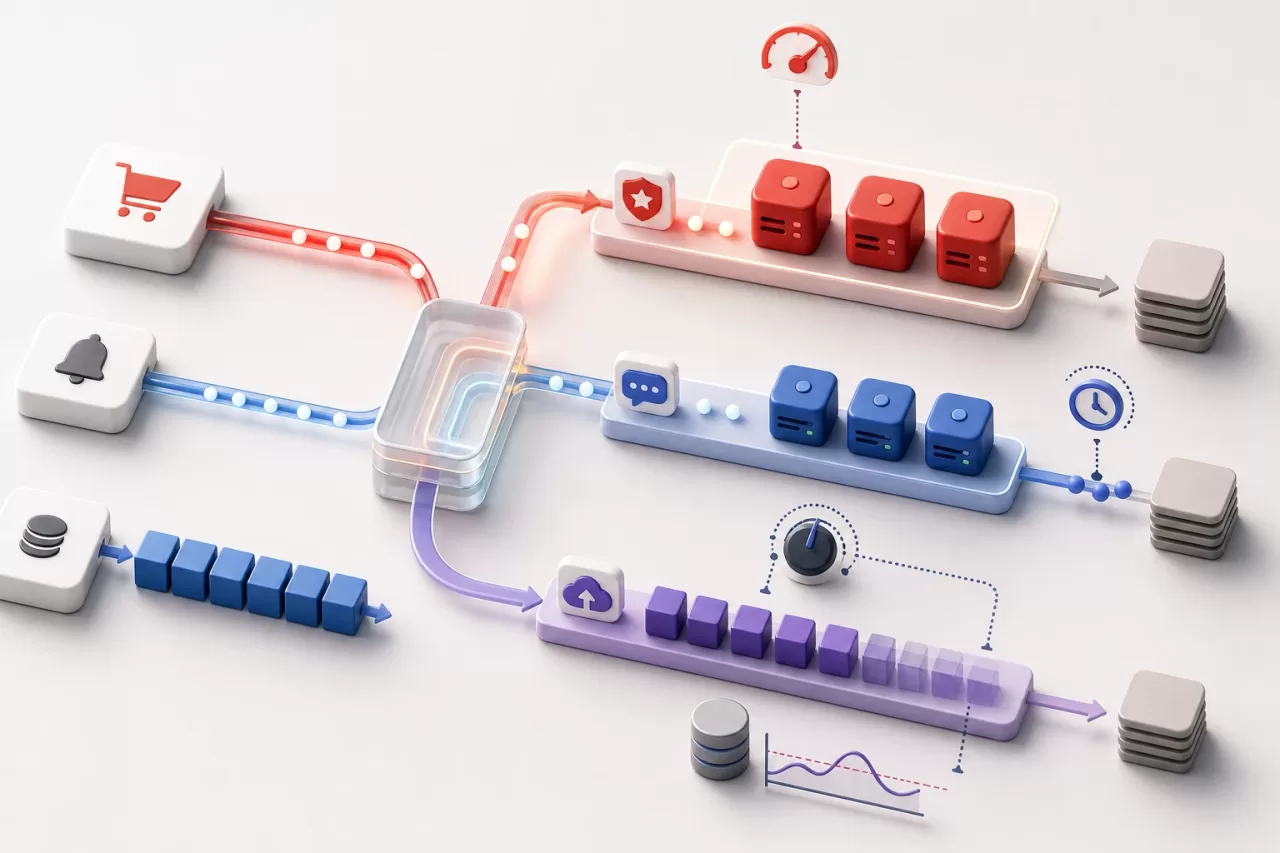
Imagine una plataforma que procesa pedidos urgentes, notificaciones y una importación masiva de catálogo. Los pedidos se enrutan a critical; las notificaciones transaccionales, a interactive; y la importación se fragmenta en páginas enviadas a bulk. Los workers de pedidos tienen capacidad reservada. La importación tiene concurrencia limitada y reduce su ritmo si aumenta la latencia de base de datos. Las notificaciones respetan la cuota del proveedor, con reintentos diferidos. Si un proceso se repite, la clave de operación evita crear dos reservas o enviar dos cambios de estado.
Para introducir este modelo en una aplicación existente:
- Inventaríe los handlers y asigne una clase de servicio basada en plazo, impacto y dependencia.
- Mida duración, espera y errores antes de cambiar el enrutamiento.
- Separe primero los flujos críticos de los masivos y reserve capacidad mínima.
- Defina límites de concurrencia por dependencia y políticas de backpressure.
- Haga idempotentes los efectos de negocio y limite reintentos y tiempos de ejecución.
- Pruebe picos de carga, caída de proveedores y una entrada masiva antes de activar el nuevo reparto.
- Revise periódicamente cuotas y clases: una prioridad es una política de negocio que cambia con el producto.
El resultado buscado no es que todo sea prioritario, sino que cada trabajo reciba una capacidad y un plazo coherentes, sin convertir una operación de gran volumen en un bloqueo para el resto del negocio.