Runbook incydentów dla aplikacji PHP przekształca alert w sekwencję kontrolowanych decyzji. Nie jest listą poleceń ani dokumentem zakładającym konkretną przyczynę: powinien wskazywać, jaki symptom wykryto, jakie dowody zebrać, jakie działania są dopuszczalne, kiedy się zatrzymać oraz kto może zdecydować o kolejnym kroku.
Jest to szczególnie ważne w aplikacjach obsługujących ruch webowy, procesy PHP działające w tle, kolejki, cron, integracje zewnętrzne i współdzielone bazy danych. Pozornie prosta interwencja, taka jak ponowne uruchomienie konsumentów lub ponowienie komunikatów, może ukryć źródło problemu, powielić operacje albo zwiększyć obciążenie usługi, która już działa w stanie degradacji.
Co rozwiązuje runbook i czego nie powinien zastępować
Runbook ogranicza improwizację podczas powtarzalnych lub przewidywalnych sytuacji. Jawnie określa kolejność kontroli, granice interwencji oraz dowody potrzebne do ogłoszenia odzyskania sprawności. Umożliwia również, aby zespoły developmentu, operacji i biznesu posługiwały się tym samym językiem podczas incydentu.
Nie zastępuje kontroli, które powinny istnieć przed incydentem:
- Obserwowalność: metryki, skorelowane logi, trace'y i alerty ze zrozumiałymi progami. Procedura nie rekompensuje niejednoznacznego sygnału ani sygnału pozbawionego kontekstu.
- Szkolenie i uprawnienia: osoby wykonujące procedurę muszą rozumieć ryzyko i mieć wyłącznie niezbędne dostępy.
- Kopie zapasowe i przetestowane odtwarzanie: backup nie jest strategią odzyskiwania, jeśli nie są znane jego integralność, zakres i czas odtwarzania.
- Architektura: idempotentne ponowienia, limity zasobów, timeouty, circuit breakery i izolacja zależności ograniczają potrzebę ręcznych interwencji.
- Zarządzanie zmianami: wdrożenie nie jest równoznaczne z release'em. Runbook powinien wiedzieć, która wersja jest aktywna i czy stopniowa ekspozycja może ograniczyć ryzyko rollbacku.
Celem nie jest udokumentowanie każdego możliwego błędu. Chodzi o standaryzację odpowiedzi na sygnały mające wpływ operacyjny i takie, w których błędna decyzja może pogorszyć stan systemu.
Kiedy alert zasługuje na odrębną procedurę
Nie każdy alert wymaga własnego dokumentu. Warto priorytetyzować sytuacje łączące częstotliwość, wpływ, presję czasową lub zależności między zespołami. Alert zasługuje na runbook, gdy reakcja nie powinna zależeć od pamiętania kroków pod wpływem stresu.
- Powtarza się i zwykle wymaga tych samych wstępnych kontroli.
- Wpływa na przychody, procesy klientów, dotrzymywanie terminów lub dostępność krytycznej funkcji.
- Działanie naprawcze jest odwracalne wyłącznie w ograniczonym oknie czasowym.
- Wymaga koordynacji między aplikacją PHP, infrastrukturą, bazą danych lub dostawcą API.
- Ręczne działanie może spowodować utratę, duplikację lub ujawnienie danych.
- Alert ma znane fałszywe pozytywy, które należy wykluczyć konkretnymi dowodami.
Zacznij od obserwowalnego symptomu, a nie od teorii. „Liczba oczekujących zadań rośnie”, „opóźnienie endpointu przekracza próg”, „rośnie liczba błędów 5xx” lub „integracja zwraca nieprawidłowe odpowiedzi” to użyteczne punkty wejścia. „Baza danych jest przeciążona” jest hipotezą wymagającą weryfikacji, a nie punktem wyjścia procedury.
Minimalna struktura wykonalnego runbooka
Użyteczny dokument operacyjny można przeczytać i wykonać podczas incydentu. Powinien unikać sformułowań takich jak „sprawdź logi” bez określenia, czego szukać, w jakim przedziale oraz jaki wynik zmienia decyzję.
- Cel i zakres: opisz objęty symptom, komponenty, których dotyczy, oraz te, które pozostają poza zakresem. Wskaż, czy dotyczy produkcji, konkretnych środowisk czy danego typu procesu.
- Sygnały wejściowe: uwzględnij alert, progi, istotne dashboardy, komunikat błędu oraz warunki odróżniające rzeczywisty alert od szumu.
- Pierwsza osoba odpowiedzialna i uprawnienia: określ, kto potwierdza incydent, kto wykonuje działania i kto zatwierdza operacje o dużym wpływie.
- Ryzyka i warunki zatrzymania: jasno wskaż, jakich działań nie należy wykonywać, jakich danych mogą dotyczyć oraz kiedy eskalować bez kontynuowania.
- Kroki i dowody: każdy krok powinien wymagać kontroli, zapisywać oczekiwany wynik i definiować kolejną gałąź decyzji.
- Zakończenie: określ, jakie dowody pozwalają zamknąć incydent i jakie działania następcze pozostają otwarte.
Wewnętrzne linki do dashboardów, repozytoriów lub narzędzi mogą być użyteczne w wersji operacyjnej, ale nie powinny być jedynym kontekstem. Zapisz, jaką metrykę obserwować, po jakiej etykiecie filtrować i jakiego okna czasowego użyć. Jeśli narzędzie nie jest dostępne, zespół powinien wiedzieć, jakie alternatywne dowody może zebrać.
Oddziel diagnozę, mitygację i odzyskiwanie sprawności
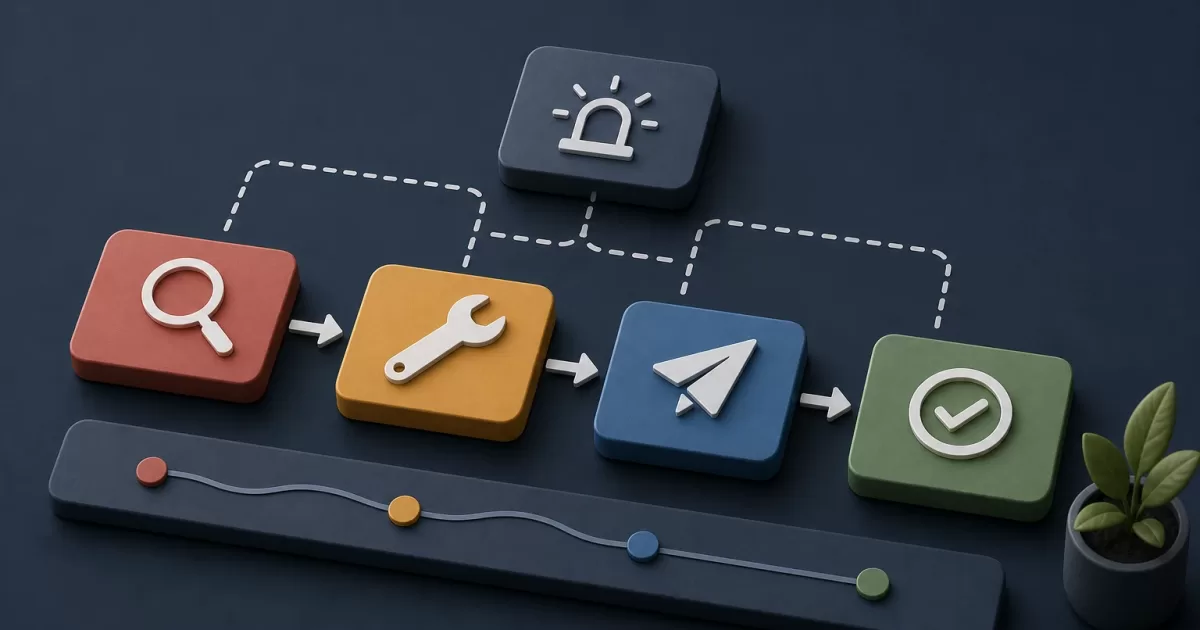
Częstą przyczyną przedłużających się incydentów jest mieszanie analizy i zmian. Runbook powinien klasyfikować działania według ich poziomu ryzyka i celu.
Bezpieczne działania i diagnoza
Potwierdzenie alertu, otwarcie kanału koordynacji, zebranie metryk, sprawdzenie logów błędów i kontrola stanu zależności są zazwyczaj działaniami niskiego ryzyka. Mimo to powinny mieć ograniczenia: kosztowne zapytania do zdegradowanej bazy danych lub niefiltrowane przeszukiwanie logów również mogą zwiększać presję.
Diagnoza powinna formułować testowalne hipotezy. Na przykład: jeśli rośnie liczba błędów połączenia, a pula połączeń jest wyczerpana, przed zmianą limitów bada się zależność i wzorzec użycia. Jeśli zawodzi tylko niedawno wystawiona wersja, porównuje się jej ruch i błędy z poprzednią wersją.
Mitygacja i odzyskiwanie sprawności
Mitygacja ogranicza szkody bez twierdzenia, że przyczyna została usunięta: ograniczenie ekspozycji funkcjonalności, wstrzymanie napływu zadań lub zastosowanie rate limitingu to możliwe przykłady. Odzyskiwanie sprawności przywraca usługę do akceptowalnego stanu: przywrócenie konsumenta, rollback wersji lub kontrolowane przetwarzanie zaległej pracy.
Każde działanie powinno zawierać punkt decyzyjny: która metryka się poprawia, jak długo jest obserwowana i co następuje, jeśli się pogarsza. Ponowne uruchomienie procesu PHP może być prawidłową, ograniczoną mitygacją, ale nie powinno być automatyczną instrukcją, jeśli występują nieidempotentne zadania, blokady bazy danych lub niewyjaśnione zużycie pamięci.
Hipotetyczny przykład: nagromadzenie zadań w kolejce PHP
Rozważ aplikację PHP z konsumentami przetwarzającymi powiadomienia, synchronizacje lub zadania handlowe. Alert wskazuje, że liczba oczekujących zadań stale rośnie. Runbook nie powinien po prostu nakazywać „opróżnić kolejkę”.
- Potwierdź zakres: zmierz liczbę oczekujących zadań według typu, wiek komunikatu, tempo napływu i tempo przetwarzania. Sprawdź, czy opóźnienie dotyczy wszystkich konsumentów, czy konkretnej ścieżki.
- Sprawdź kondycję konsumentów: aktywne procesy, restarty, pamięć, błędy PHP, timeouty i powtarzające się wyjątki. Sprawdź również łączność z kolejką i zależności wywoływane przez zadania.
- Sklasyfikuj hipotezę: nienormalnie wysoki napływ, niewystarczająca przepustowość, zablokowane zadanie, błąd w kodzie, powolna zewnętrzna zależność lub nieprawidłowe dane. Nie zwiększaj liczby konsumentów, jeśli zależność docelowa jest już przeciążona.
- Określ limity ponowień. Komunikaty, które wielokrotnie kończą się niepowodzeniem, powinny trafiać do ścieżki weryfikacji lub kolejki błędów, gdy projekt na to pozwala; ponawianie ich bez limitu może zwiększyć ruch i powielić skutki.
- Zastosuj stopniowe odzyskiwanie sprawności: przywracaj lub skaluj konsumentów etapami, obserwuj wskaźnik sukcesu oraz monitoruj błędy, opóźnienia i obciążenie bazy danych. Utrzymuj warunek zatrzymania, jeśli backlog rośnie szybciej lub liczba błędów się zwiększa.
- Zweryfikuj wynik: sprawdź, czy liczba starych zadań maleje, czy nie ma duplikatów, czy powiązane operacje są spójne i czy alert stabilizuje się przez określone okno czasowe.
Jeśli zadania wywołują skutki zewnętrzne, takie jak obciążenia, e-maile lub zmiany stanu magazynowego, runbook powinien wymagać weryfikacji przez człowieka przed ponownym przetwarzaniem partii. Idempotencja ogranicza ryzyko, ale nie należy jej zakładać bez dowodów wynikających z projektu i danych, których dotyczy.
Chroń dane wrażliwe i operacje nieodwracalne
Procedura dotycząca danych osobowych, poświadczeń, zamówień, płatności lub rejestrów regulacyjnych wymaga dodatkowych kontroli. Nie wystarczy, że polecenie jest poprawne technicznie.
- Stosuj minimalne uprawnienia i odrębne konta do odczytu, interwencji operacyjnej oraz administracji.
- Wymagaj podwójnego potwierdzenia dla usunięć, masowego ponownego przetwarzania, odtwarzania lub bezpośrednich modyfikacji danych.
- Rejestruj, kto zatwierdził i wykonał działanie, jaki zakres danych ono obejmowało oraz jaki wynik uzyskano.
- Określ próbkę walidacyjną przed działaniem na całym zbiorze.
- Ustal wyraźny warunek zatrzymania w przypadku rozbieżności, niezidentyfikowanych danych lub skutków wykraczających poza początkowy zakres.
Unikaj umieszczania sekretów w runbooku, logach lub zrzutach ekranu. Dokument może wskazywać zatwierdzony system uzyskiwania tymczasowych poświadczeń, ale nie powinien przekształcać informacji wrażliwych w trwały tekst.
Eskalacja i weryfikacja po odzyskaniu sprawności
Eskalacja nie jest porażką zespołu obsługującego alert; jest decyzją o kontroli ryzyka. Eskaluj do developmentu, gdy istnieje możliwy defekt aplikacji, regresja wersji lub nieidempotentne zachowanie. Eskaluj do infrastruktury, jeśli występuje wyczerpanie zasobów, problem z siecią, pamięcią masową lub platformą wykonawczą. Zaangażuj zewnętrznego dostawcę, gdy dowody wskazują na jego API lub usługę. Poproś o decyzję biznesową, jeśli mitygacja wymaga wstrzymania sprzedaży, opóźnienia komunikacji lub zaakceptowania innej kolejności przetwarzania.
Określ ponadto maksymalny czas dla każdej fazy. Jeśli po wstępnej diagnozie nie ma wystarczających dowodów lub jeśli mitygacja nie poprawia sygnału w oczekiwanym przedziale, osoba odpowiedzialna powinna eskalować zamiast powtarzać działania.
Odzyskiwanie sprawności kończy się, gdy zweryfikowano coś więcej niż zniknięcie alertu:
- Początkowy symptom pozostaje w granicach przez okno obserwacji.
- Zaległa praca, transakcje i dane, których dotyczy incydent, są spójne.
- Użytkownicy mogą ukończyć istotne przepływy bez zauważalnej degradacji.
- Powiązane alerty nie wykazują skutków ubocznych po zmianie.
- Udokumentowano chronologię, potwierdzone lub odrzucone hipotezy, działania i oczekujące usprawnienia.
Przejrzyj runbook po jego użyciu. Usuń kroki, które nie dostarczyły dowodów, uwzględnij decyzje, które okazały się konieczne, a powtarzające się ustalenia przekształć w usprawnienia obserwowalności, testów lub architektury. W ten sposób procedura przestaje być statyczną dokumentacją i staje się narzędziem bezpiecznego odzyskiwania sprawności.