Uma aplicação pode ter dezenas de métricas técnicas no vermelho e, ainda assim, continuar prestando o serviço principal. Também pode ocorrer o contrário: CPU, memória e conectividade parecem normais, mas os usuários não conseguem concluir uma operação crítica. O objetivo dos alertas acionáveis para aplicações PHP não é detectar toda anomalia, mas avisar quando uma pessoa deve tomar uma decisão concreta para limitar uma consequência operacional.
Um alerta útil responde, antes de abrir um painel, a quatro perguntas: qual capacidade está afetada, quem é afetado, desde quando e qual ação inicial é segura. Se não permite formular uma hipótese ou decidir uma intervenção, provavelmente é telemetria de diagnóstico, não um alerta de plantão.
Separar sinais, sintomas e incidentes
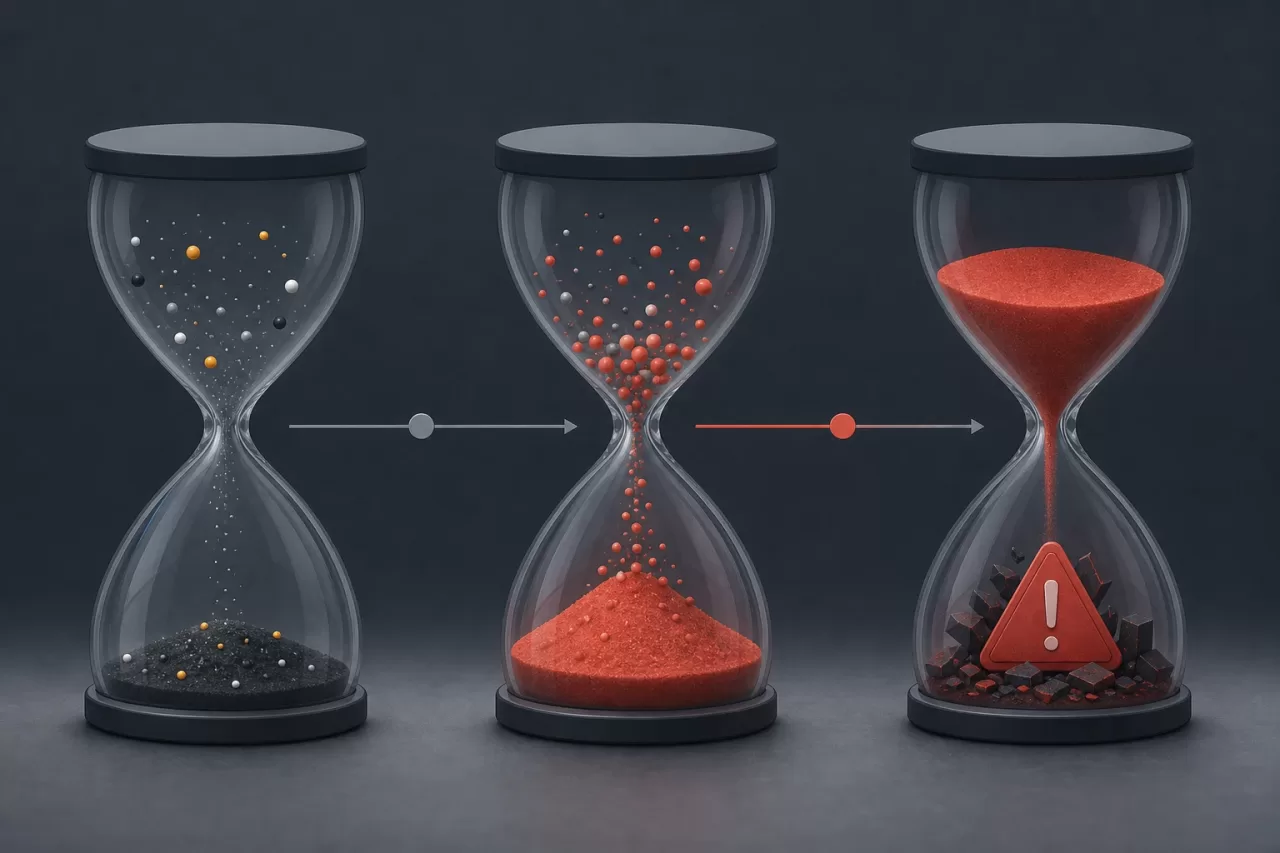
Um sinal é uma observação isolada: aumento do uso de conexões, reinicializações de processos PHP-FPM, crescimento de uma fila ou uma resposta lenta de uma API. Um sintoma expressa degradação observável do serviço: mais erros ao confirmar pedidos, trabalhos críticos que não terminam dentro do prazo ou um aumento sustentado da latência de uma rota relevante. Um incidente é a situação que exige coordenação e resposta devido ao seu impacto real ou previsível.
Essa distinção evita transformar cada métrica de infraestrutura em uma interrupção. Por exemplo, uma saturação transitória de CPU pode ser útil para investigar capacidade. Ela deve escalar para alerta se coincidir com requisições com falha ou com uma latência que impeça o uso de uma função prioritária. Da mesma forma, um número elevado de exceções PHP merece atenção quando se concentra em uma operação de negócio ou afeta uma proporção relevante das solicitações, não apenas porque existe nos logs.
- Sinais de diagnóstico: consumo de disco, número de processos, acertos de cache, tentativas individuais ou rastros de exceção.
- Sintomas alertáveis: indisponibilidade, taxa sustentada de falhas em um fluxo crítico, atraso de processamento ou esgotamento iminente de um recurso com efeito verificável.
- Indicadores de incidente: alcance de usuários, possível perda ou duplicação de dados, descumprimento de um prazo operacional e ausência de uma alternativa manual razoável.
Construir um mapa mínimo do serviço
Antes de definir limiares, desenhe o percurso dos fluxos relevantes. Não é necessário inventariar toda a plataforma: basta representar as rotas que entregam valor ou geram risco. Em uma aplicação PHP comum, aparecem a requisição web, autenticação, lógica de domínio, banco de dados, cache, publicação em fila, consumidores assíncronos e APIs de terceiros.
Para cada trecho, documente qual entrada ele recebe, qual resultado observável deve produzir, de qual dependência precisa e como se comporta diante de uma falha. Uma requisição pode responder corretamente após enfileirar um trabalho, embora a ação final ainda não tenha sido concluída. Por isso, monitorar apenas o código HTTP da camada web deixa a equipe sem visibilidade sobre atrasos ou erros do processamento assíncrono.
Priorizar por consequências, não por componentes
Classifique cada fluxo conforme sua consequência caso pare: perda de receita, descumprimento operacional, exposição de dados, bloqueio do suporte ou simples degradação estética. Depois, identifique uma medição que comprove a consequência. Para um cadastro de usuário, pode ser a criação confirmada da conta; para uma importação, a idade do item pendente mais antigo; para uma integração de faturamento, o percentual de operações que termina em um estado recuperável ou definitivo.
É recomendável manter verificações sintéticas de fora do processo PHP para os percursos essenciais. Uma verificação interna pode indicar que o processo está ativo, mas não que o balanceamento de carga, as credenciais, o armazenamento de sessão e a rota de negócio funcionem em conjunto.
As quatro famílias de alertas que costumam orientar decisões
A disponibilidade percebida mede se é possível concluir uma operação representativa. Ela pode combinar uma verificação sintética com o percentual de respostas corretas de rotas críticas. É mais valiosa do que alertar por um processo isolado, embora ambos os dados possam coexistir no diagnóstico.
Os erros de negócio capturam resultados incorretos que um código HTTP não revela: validações que falham inesperadamente, pagamentos recusados por uma mudança interna, documentos não gerados ou transições de estado impossíveis. Devem usar eventos de domínio com identificadores que permitam investigar sem incluir informações pessoais desnecessárias.
A latência deve ser medida por rota e por percentis, não apenas por médias. Uma média aceitável pode ocultar uma minoria de solicitações excessivamente lentas. Alerte quando a latência se mantiver e afetar uma operação relevante; um pico breve pode exigir observação, não acordar uma pessoa.
O atraso de processamento mede o tempo desde que um trabalho é aceito até sua conclusão. É especialmente importante em filas porque o número total de mensagens nem sempre implica urgência: um acúmulo grande pode ser normal se os consumidores o drenarem dentro do prazo exigido.
Definir limiares a partir da linha de base
Não copie um valor genérico de CPU, latência ou tamanho de fila. Reúna uma linha de base por faixa horária e por tipo de carga, incluindo picos previsíveis. Em seguida, defina o nível a partir do impacto: quanto um fluxo pode demorar antes de descumprir uma expectativa do usuário, uma janela operacional ou uma obrigação interna.
Uma regra sólida combina quatro elementos: uma janela de avaliação, persistência mínima, magnitude e alcance. Por exemplo, não basta detectar um aumento de erros; estabeleça que o aumento persista durante várias janelas e represente uma fração significativa das operações do fluxo. Assim, reduzem-se avisos por deploys transitórios, retries bem-sucedidos ou tráfego anômalo isolado.
Diferencie o deploy, que instala uma versão, da release, que habilita uma mudança de comportamento para os usuários. Ambos são contexto relevante, mas não são equivalentes. Um alerta após um deploy pode orientar uma reversão ou uma investigação técnica; um alerta após uma ativação gradual pode exigir interromper a exposição da mudança antes de reverter código.
Filas, banco de dados e integrações externas
Filas: monitorar a idade e a capacidade efetiva
Para cada fila crítica, meça a idade do trabalho pendente mais antigo, a taxa de entrada, a taxa de conclusão, as falhas definitivas e as tentativas. Adicione sinais sobre consumidores disponíveis e duração de execução. O alerta mais acionável geralmente se baseia na idade: ele relaciona diretamente o atraso ao compromisso do fluxo.
Um crescimento da fila é diagnóstico até superar a capacidade de drenagem ou ameaçar um prazo. Se a idade, os erros e a falta de consumidores aumentarem simultaneamente, o aviso deverá agrupar esses sintomas sob uma possível degradação do processamento, em vez de enviar um por métrica.
No banco de dados, priorize esgotamento de conexões, erros de conexão sustentados, bloqueios prolongados e latência de consultas que se traduza em rotas lentas ou com falha. Uma consulta custosa identificada na observabilidade é um sinal para otimização; ela se torna um alerta quando gera um sintoma do serviço. Para APIs externas, meça disponibilidade, latência, códigos de erro, limites de cota e tentativas. Separe as falhas recuperáveis das definitivas e verifique se existe fila, cache, modo degradado ou procedimento manual.
Anexar contexto e classificar a resposta
Uma notificação deve incluir o nome do serviço e do fluxo afetados, severidade, início e evolução, alcance estimado, região ou ambiente, métricas que dispararam a regra, versão implantada ou mudança ativada recentemente e acesso aos painéis de investigação. Inclua também os primeiros passos seguros: verificar o estado dos consumidores, validar credenciais de uma dependência, pausar uma ativação gradual ou conferir erros por categoria.
Evite instruções automáticas destrutivas, como esvaziar uma fila ou reiniciar indiscriminadamente. A automação de recuperação deve ter limites, registro, reversibilidade e uma condição clara para escalar à revisão humana.
- Informativo: anomalia sem impacto atual que deve ser observada no horário de trabalho.
- Intervenção planejada: degradação que ameaça um prazo, mas conta com margem e alternativa operacional.
- Escalonamento imediato: operação crítica indisponível, risco de dados, acúmulo irrecuperável ou impacto crescente sem mitigação conhecida.
Evitar fadiga e revisar cada regra
Elimine eventos duplicados, agrupe alertas por causa provável e limite a repetição enquanto o incidente permanecer aberto. Um alerta secundário deve enriquecer o principal, não competir com ele. Se um provedor externo falhar e provocar tentativas, erros de aplicação e atrasos na fila, a notificação central deve descrever a dependência provável e anexar os sintomas correlacionados.
Após cada incidente, revise se faltou um alerta antecipado, qual chegou sem produzir uma decisão e qual evidência permitiu identificar a causa. Remova ou rebaixe regras que apenas geram confirmações rotineiras. Meça o resultado qualitativamente: se a pessoa que recebe entende o impacto e executa um primeiro passo apropriado sem buscar contexto disperso, a regra está cumprindo sua função.
Exemplo de design para um fluxo assíncrono
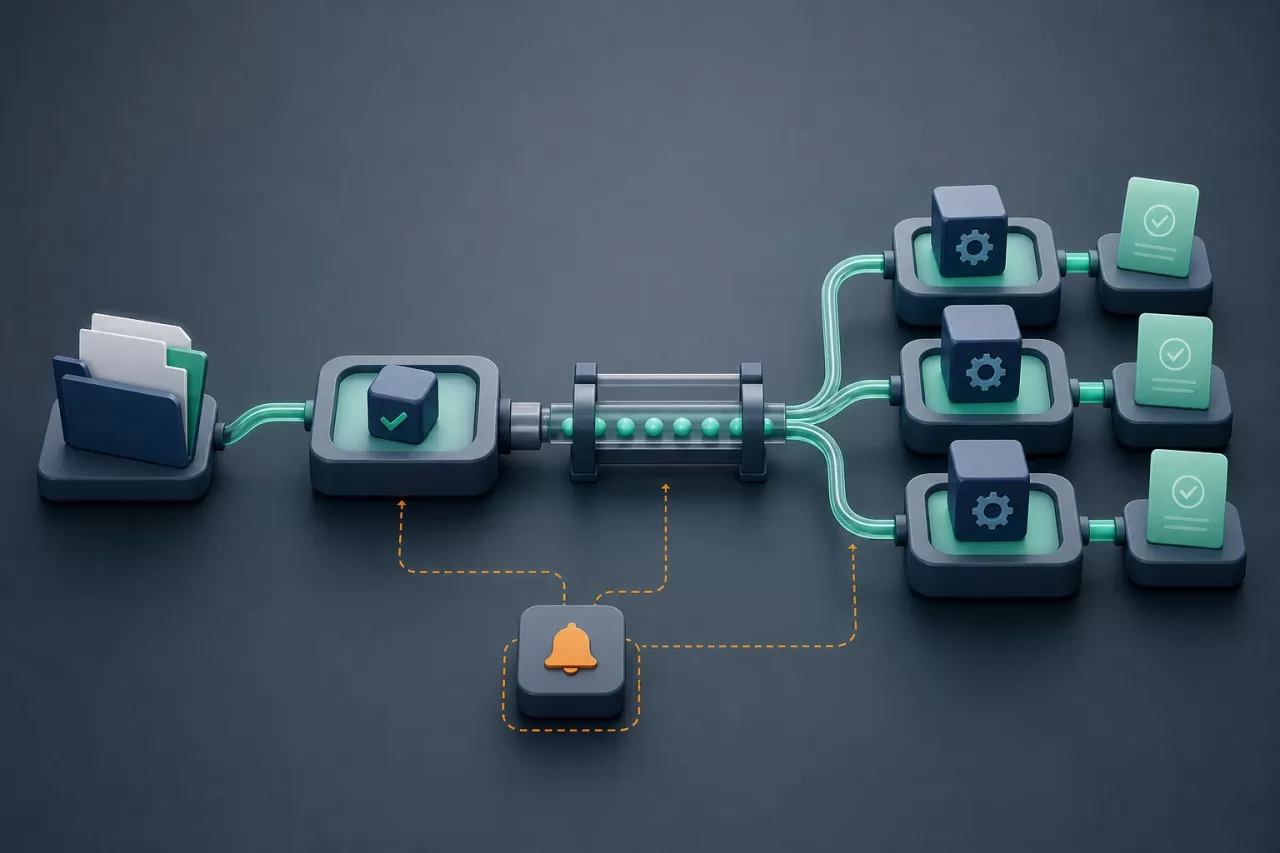
Imagine um fluxo de recebimento, validação e processamento posterior de arquivos. A requisição PHP confirma o recebimento após salvar metadados e publicar um trabalho. Os consumidores validam o conteúdo e geram um resultado. Os alertas não devem se limitar a detectar que a fila contém mensagens.
- Alerta de disponibilidade se o recebimento falhar de forma sustentada em uma proporção relevante das solicitações.
- Alerta de atraso se a idade do trabalho pendente ultrapassar o prazo aceitável para entregar o resultado.
- Alerta de qualidade se aumentarem as falhas de validação por uma causa interna, diferenciando-as de arquivos inválidos enviados pelos usuários.
- Alerta de dependência se o armazenamento ou uma API necessária responder com falhas sustentadas e não existir uma rota de recuperação automática efetiva.
Para publicar uma nova regra, verifique por fim: fluxo e responsável definidos, impacto expresso em termos operacionais, linha de base disponível, limiar com janela e persistência, severidade justificada, deduplicação configurada, contexto anexado, primeiro passo seguro documentado e revisão prevista. Esse filtro transforma os alertas acionáveis para aplicações PHP em um sistema de decisão, não em outra fonte de interrupções.